Nginx Round-Robin 负载均衡:默认策略的实测与边界
Nginx 做反向代理时,多个后端怎么分流量是最先要回答的问题。Round-Robin(轮询)是最基础的答案:请求按顺序逐个分给后端,分完一轮再从头来。它还是 Nginx 的默认策略——upstream 块里不写任何负载均衡指令时,用的就是轮询,简单到容易被当成”理所当然不看第二眼”的东西。但轮询在什么分布下才均匀、后端宕机时流量怎么走,值得实测一遍再说。
本文按配置实战组织:先交代实验环境,然后实测轮询序列、加权分布、宕机转移三个关键行为,最后给一组容易写错的配置对比。所有输出均为 nginx/1.31.5 实跑结果。
实验环境
所有实例在单个容器里可复现:nginx/1.31.5(docker 镜像 nginx:alpine),用三个 server 块监听 8081/8082/8083 模拟三台后端(分别返回 backend1/2/3),80 端口反代 upstream;access_log 记录 $upstream_addr 观察每笔请求实际落在哪台后端。判断”流量分给了谁”,猜是没有用的——这个变量给出的是确定答案,宕机排查时同样适用。本实验把 worker_processes 固定为 1,原因见实测一的观测陷阱。
什么场景适合轮询
先把适用边界说清楚,再看实测:
- 后端配置相近:机器性能差不多时,轮询天然均分,不需要调参。
- 请求无状态:请求落到哪台都一样(会话不粘机器)时,轮询最自然。
- 流量轻到中等:小应用没必要上更复杂的策略,默认值就是好答案。
反过来说,后端性能悬殊、需要会话保持的场景,轮询不是好选择——后者见文末注意事项。
实测一:轮询序列
先看最基础的均匀分发:
1 | upstream backend { |
连发 6 次,正好两整轮,access_log 里的 $upstream_addr 记录了真实路由:
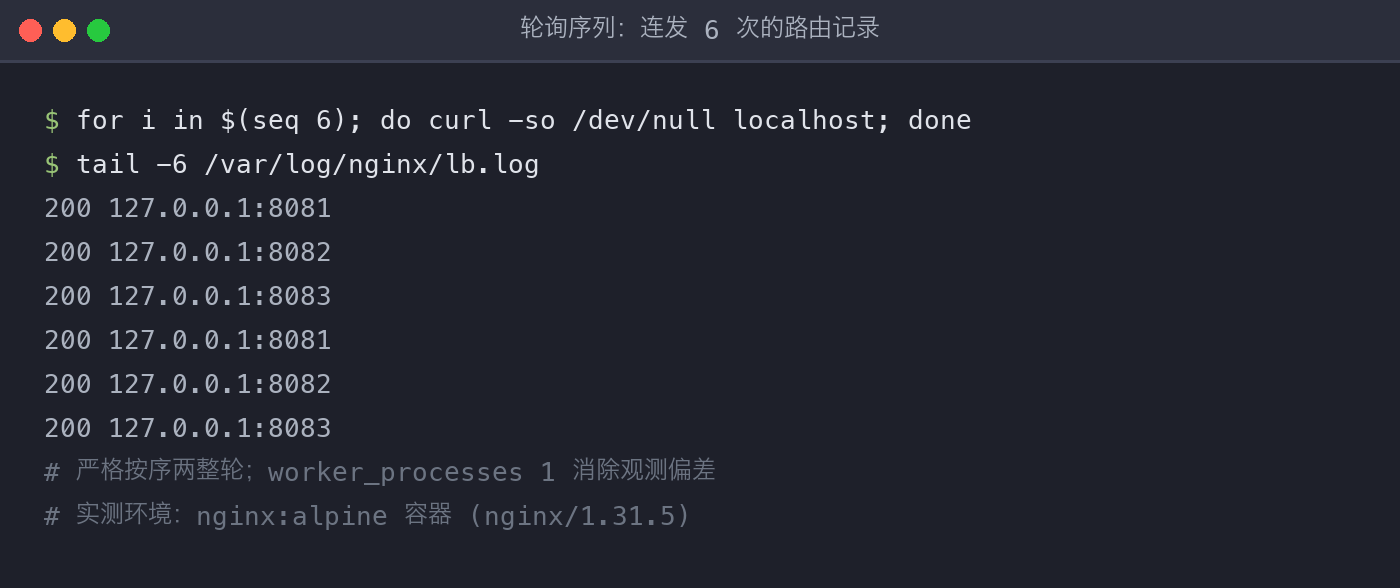
严格按序轮换,分完一轮再从头来。
生产配置里 location 通常还要带一组头传递,让后端拿到真实客户端信息,别省:
1 | location / { |
X-Forwarded-For 用 $proxy_add_x_forwarded_for 追加而不是覆盖,多级代理下后端才能看到完整链路;不传 Host,后端应用拿到的永远是 upstream 名字而不是用户访问的域名。
要提醒一个实测中真实踩到的观测陷阱:这套实验最初在默认配置(worker_processes auto)下跑,9 个请求 6 次落在 8081——轮询指针是每个 worker 独立维护的,短连接少量请求分散到多个 worker 时,多数请求恰好是各 worker 的”第一个请求”,全都从列表第一个后端开始。压测看到”不均”先查 worker 数和请求量,别急着给轮询判死刑;本实验把 worker 固定为 1 后序列完全严格。
实测二:weight 加权,性能不均的拉平手段
机器性能有差距时,给强机器加权:
1 | upstream backend { |
连发 10 次实测:
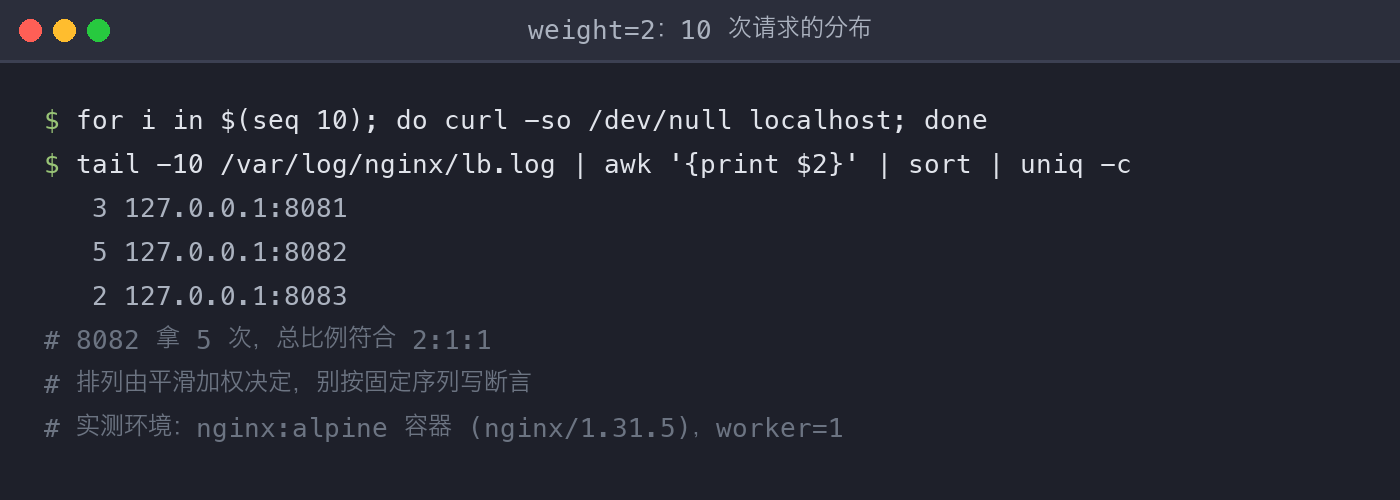
8082 拿到 5 次、8081 和 8083 各 2-3 次,总比例符合 2:1:1。注意排列不是”8082 连发两次再轮别人”——Nginx 用平滑加权算法把高权重机器的请求错开插入,避免瞬间压力集中。所以别按固定序列写断言脚本,按比例验收才对。
顺带把 upstream 里的邻居策略放在一起认一下:least_conn 挑当前连接数最少的后端,适合请求耗时差异大的服务;ip_hash 按客户端 IP 固定映射后端,是会话保持的最省事解法;random two 随机挑两台再选连接数少的那台(least_time 变体需商业版)。它们都写在 upstream 块里替代默认轮询,与 weight、max_fails 这些 server 级参数可以叠加使用。
实测三:后端宕机,流量怎么走
把 8083 的监听停掉模拟宕机(配置里它还在 upstream 列表里),带 max_fails=3 fail_timeout=30s 连发 12 次:
1 | upstream backend { |
实测结果:
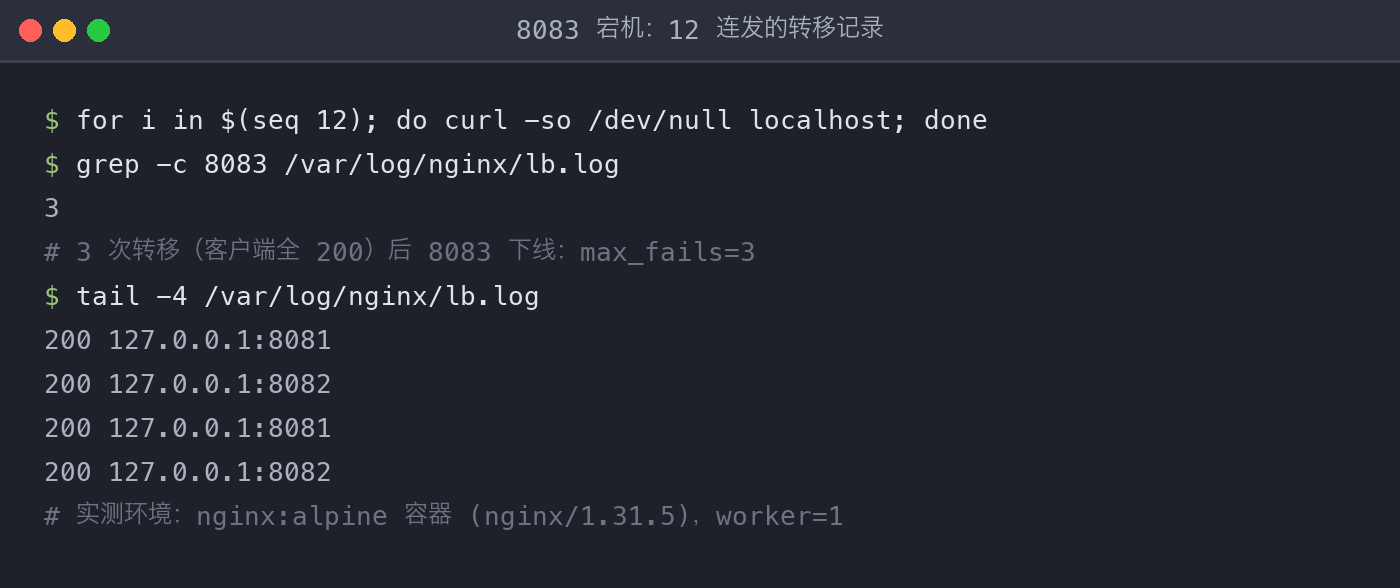
客户端拿到的是清一色 200——宕机转移对用户完全透明。12 笔请求里 8083 被实际尝试 3 次(第 3、5、8 笔,error_log 里对应三条 connect() failed (111: Connection refused)),$upstream_addr 记作 8083, 8081 这样的两段:先试 8083 失败,立即转给下一台应答。3 次失败凑满 max_fails=3,8083 被标记下线,尾段 4 笔再无 8083,30 秒内不再尝试;窗口过期后 Nginx 会拿一笔请求去探测(实验里确实观察到重试),依旧失败就重新计时——后端恢复后会自动回归轮换。这就是 max_fails/fail_timeout 这对参数的意义:被动健康检查,用失败计数代替主动探测,小规模部署够用。
一组对比:容易写错的配置
错误一:把轮询当成指令去写
1 | # 错:nginx 没有 round_robin 指令 |
实测 nginx -t 直接报 unknown directive "round_robin"——轮询是缺省行为,不是一个指令,官网文档里也找不到它的语法条目。
错误二:以为观测不均就是轮询坏了——上文实测一的多 worker 陷阱,先固定 worker_processes 1 或加大请求量再下结论。
注意事项
- 会话保持:需要 session 粘在固定机器上的应用,轮询不是好选择,考虑
ip_hash或把会话状态外置到 Redis。 - 权重改动要 reload:weight 改的是请求比例,修改配置后 reload 才生效,不是运行时动态调整;调整线上权重时留意瞬时抖动。
- 慢机器保护:性能差异大时用 weight 拉平,或给慢机器设
max_conns限流,防止慢节点拖长整体 P99。 - keepalive 不是自动的:upstream 里的
keepalive 32想真正生效,必须配proxy_http_version 1.1;和proxy_set_header Connection "";两行,清掉默认的 HTTP/1.0 短连接行为(官方文档明确要求,本文未单独实测复用效果)。注意它是每个 worker 到后端的空闲连接”蓄水池”,不是并发上限。 - backup 备机:
server ... backup;平时不接流量,其余非 backup 节点全挂(或被剔除)才顶上,和 max_fails 的被动剔除是互补的两层——前者管”谁来接盘”,后者管”坏节点退场”。
小结
三个实测串起来看:轮询本身严格按序(多 worker 观测假象除外),weight 按比例拉平机器差异,宕机后靠 max_fails/fail_timeout 被动剔除、转移对用户透明。默认策略的正确姿势是——默认配置放心用,出了不均先查观测口径,性能悬殊和会话粘性才是它真正的边界。下一台 Nginx 上线前,把这三个行为各 curl 一遍,比任何文档都踏实。
本文由作者 2020-2024 年间的 CSDN 博客文章重构而来,原发布于 CSDN。