用 Nginx split_clients 模块做 A/B 测试与灰度发布
新首页设计到底比旧的好不好?新功能敢不敢直接全量上?A/B 测试和灰度发布都是同一个问题的不同问法:怎么把流量按比例、稳定地分成几组。Nginx 的 split_clients 模块(ngx_http_split_clients_module)在接入层就把这件事办了——对用户特征做哈希,按百分比切分流量,不需要应用代码参与。
本文按配置实战组织:先交代实验环境,再实测三件事——分组是否稳定、比例是否可信、调整比例会发生什么。所有输出均为 nginx/1.31.5 实跑结果。
使用场景
- A/B 测试:两个版本的页面各分一半流量,比较转化率和用户反馈,看哪个版本更有效。
- 灰度发布:先给小比例用户放出新功能,观察没有问题再逐步放大,控制发布风险。
- 按用户特征路由:根据 IP、User-Agent 等特征把特定用户群路由到不同的后端或版本。
三个场景共享同一个前提:分组依据能从请求里直接拿到——IP、User-Agent、Header、Cookie 值都行,split_clients 只是负责”拿这个特征切比例”。需要按登录身份分组的,把用户 ID 放进 Header 或从 cookie 取值喂给特征串,一样适用;但特征串拿不到的深层信息(如数据库里的用户分层),就不是接入层能做的事了。
配置示例
用 IP 加 User-Agent 把用户分成两组,分别访问两版首页:
1 | split_clients "${remote_addr}${http_user_agent}" $variant { |
拆开看:
split_clients的第一个参数"${remote_addr}${http_user_agent}"是参与分组的用户特征串;$variant是分组结果存放的变量。- 块内
50% "A"表示特征串哈希落在前 50% 区间的请求,$variant值为"A";* "B"是兜底分支,吃掉剩余的所有流量。比例和分支数量都可以按需调,比如10%、20%、*做三档灰度。 - location 里直接把
$variant拼进 root 路径,A 组读/var/www/version_A,B 组读/var/www/version_B——变量拼接比原文的成对if更省,也没有 if 的诸多限制。
分组结果既然是个普通变量,用法就不止切 root:给 proxy_pass 的 upstream 挑版本、往响应里加 add_header X-Variant $variant 方便前端埋点和排查、写进日志格式统计各组实际流量,都是同一套思路。和 map 指令的分工也值得记一句:map 是”特征精确等于某值就映射成某值”(按内容匹配),split_clients 是”按哈希值切比例”(按概率分组)——复杂的灰度系统两者常串联:先用 map 把杂乱特征归一化(比如从不同 cookie 里取出用户标识),再喂给 split_clients 切比例。实验里顺带踩了一个拼接细节:分支值区分大小写,"A" 拼出的目录是 version_A,目录名大小写不一致就是 404/403,实测中先踩的正是这个坑。
实测一:同一用户看到的版本是固定的
对特征串做的是确定性哈希:同一个 IP 加同样的 User-Agent,哈希值每次都一样,落在哪个区间就永远是哪个版本。用同一个 UA 连发三次、换一个 UA 再发:
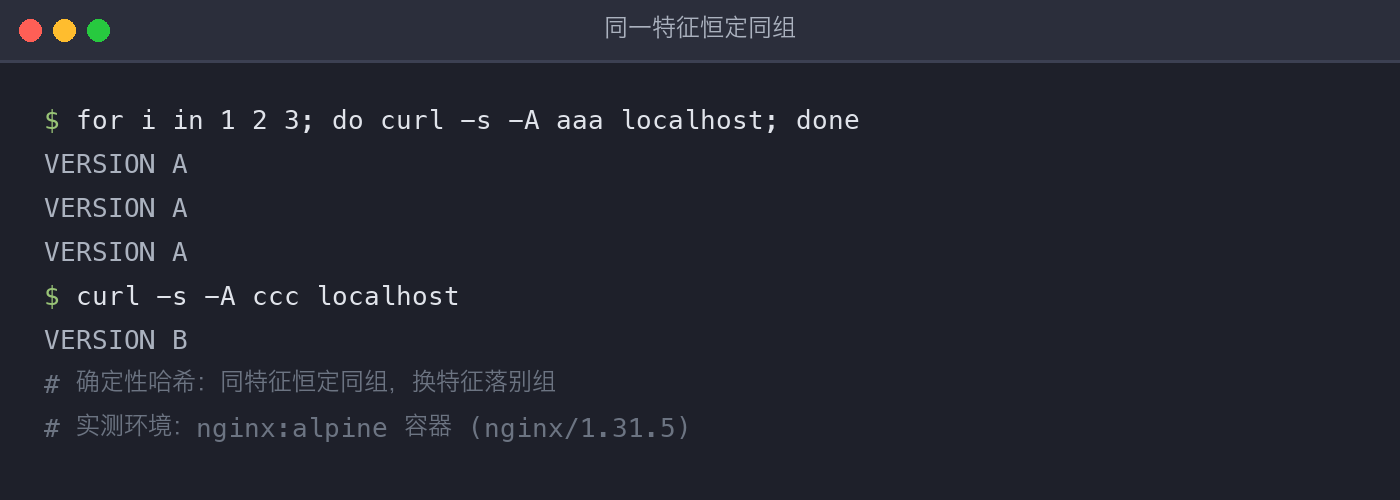
同一特征恒定 VERSION A,换特征落到 B 组——这就是 A/B 测试要求的数据一致性:用户不会这会儿看到 A 版、刷新一下变成 B 版。
实测二:比例可信吗
分流准不准,数一数才知道。用 20 个不同 User-Agent 模拟 20 个独立用户:
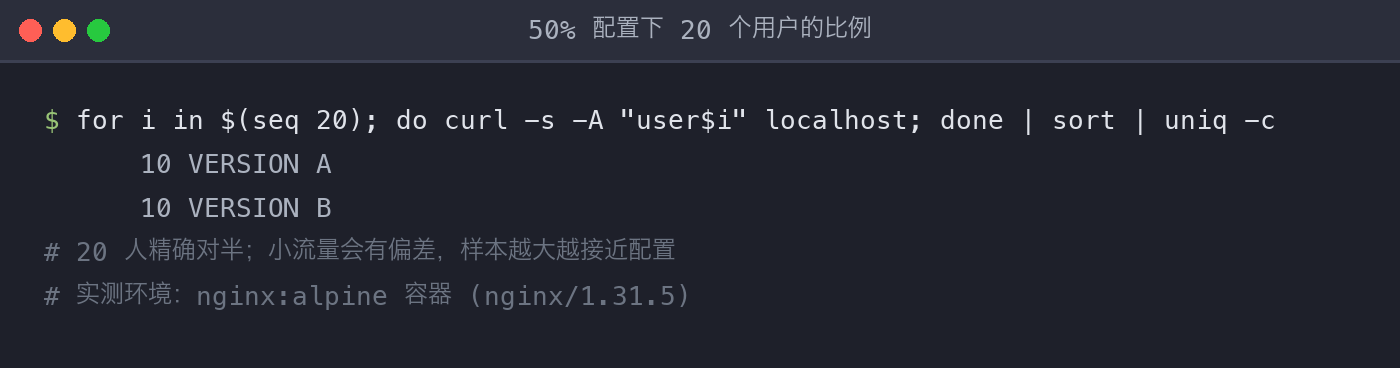
10 比 10,精确对半。注意 50% 是哈希意义上的均分——小流量下组间人数会有明显偏差,样本越大越接近配置比例,别在小样本上硬读数据。
实测三:调整比例会重排所有人
把配置从 50% 改成 25%,reload 后重跑统计:
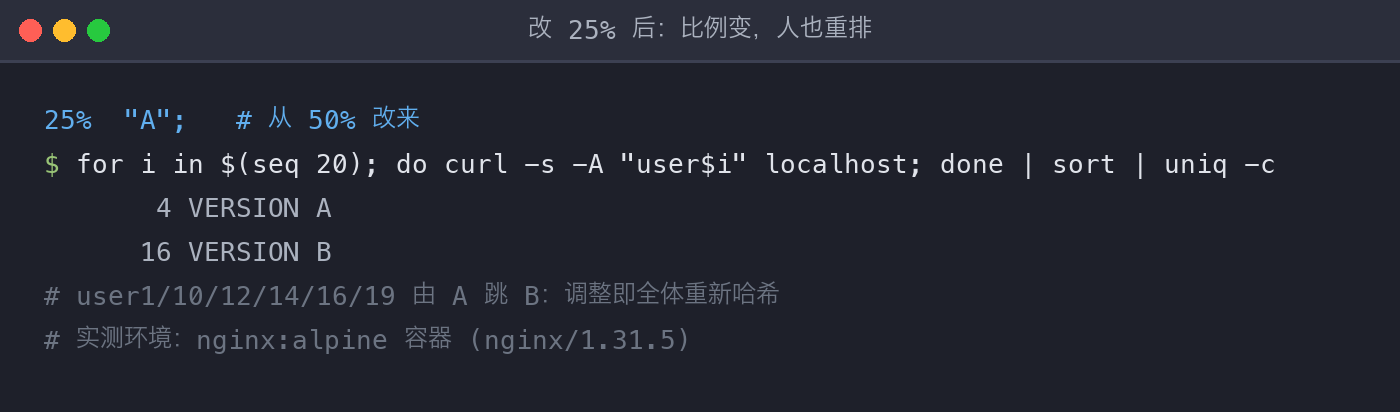
20 个用户的分布变成 4 比 16,符合 25% 的设定;但更要紧的是另一件事——对比改动前后每个用户的落组,改动前在 A 组的 user1、user10、user12、user14、user16、user19 改动后全部落到 B 组。比例不是在原有分组上”划走一块”,而是全体用户重新哈希。正在进行的 A/B 测试中途改比例,前后两段数据就不可比了;灰度放大流量也一样,会有部分用户”版本跳变”。
要缓解跳变,常见做法是把分组键换成首访时随机分配、之后恒定不变的 cookie:split_clients "${cookie_ab_group}" $variant { ... }——老用户粘在自己首次的组里,只有没有 cookie 的新流量参与哈希;代价是引入应用层配合,同时要处理”特征串为空”的边界:没有 cookie 的请求拿空串去哈希,全部落进同一个桶,等于天然聚成一组。把哪个值喂给特征串,决定了”谁是同一用户”,这是这个模块真正要想清楚的地方。
注意事项
- 特征串要稳定:同一用户在整个测试期间必须落在同一组,IP 会变的场景(移动网络、共享出口)优先用更稳定的标识,有登录态就把用户标识加进特征串。
- 比例是近似值:50% 是哈希意义上的大致均分,流量小时组间人数会有明显偏差,样本小时先看置信度再下结论。
- 改配置要 reload 且会全员重排:正在进行的测试中途不要动比例或特征串(上文实测重排效应)。
- 性能开销很小:每次请求多一次哈希计算,常态下可以忽略。
小结
三个实测拼出 split_clients 的完整画像:分组靠确定性哈希,稳定到同一用户永不跳版本;比例在哈希意义上可信,样本够大就逼近配置值;代价是调整即重排,测试中途动配置等于作废数据。它适合”接入层按比例切流”这类轻量 A/B 与灰度;需要跨请求强一致分组(cookie 固定、登录态绑定)时,就该让应用层接手了。上线前用固定 UA 各打几发确认分组和比例,是这个模块最快的验收方式。
本文由作者 2020-2024 年间的 CSDN 博客文章重构而来,原发布于 CSDN。