
ZooKeeper 集群部署:Rocky Linux 9 三节点实战(附 CentOS 7 差异)
ZooKeeper 在分布式系统里干的活不算显眼,但缺了它很多组件跑不起来:Kafka 的元数据、Hadoop 的高可用选主、各类中间件的配置协调都靠它。这类组件的特点是一旦上线就轻易不动,所以第一次部署值得花心思装对。本文记录在 Rocky Linux 9.3 上搭一套三节点 ZooKeeper 3.8.6 集群的完整过程——从装 Java 到跨节点读写验证,CentOS 7 时代的差异放在文末单列。
环境与验证边界:本文全部命令在三个 Rocky Linux 9.3 容器(自定义 docker 网络,主机名 zk1/zk2/zk3 互通)里真实执行并验证,选举、读写、节点重连均为实测输出。物理机/虚拟机部署的步骤与此完全一致,只是节点 IP 换成真实地址。
系统和环境准备
示例环境是三台 Rocky Linux 9 机器,下文用 zk1、zk2、zk3 指代。开始前确认两件事:节点之间网络互通(后面的 2888/3888 端口靠它),机器时间保持同步(Rocky 9 默认装了 chronyd,chronyc sources 有输出即可)。
安装 Java 环境
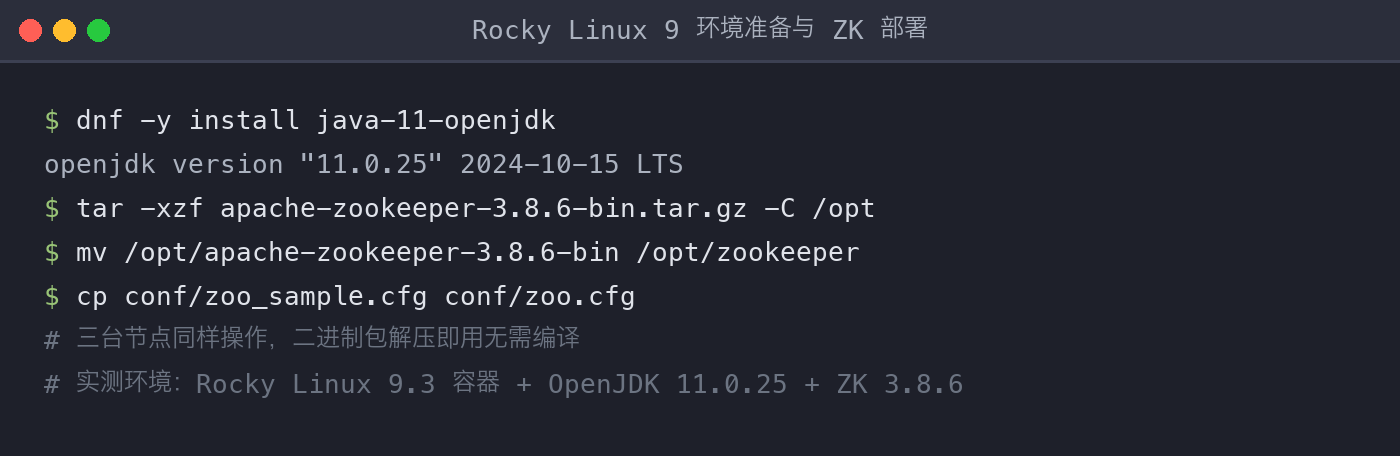
ZooKeeper 是 Java 写的,所有节点都要先有 Java 环境。ZooKeeper 3.8 支持 Java 8/11/17,Rocky 9 的 AppStream 源里都有,装 11 最稳妥:
1 | dnf install java-11-openjdk -y |
第二条命令用来确认安装结果,能看到 openjdk version "11.0.x" 的输出就说明 Java 已经就位。
安装 ZooKeeper
从 Apache 官网下载二进制包,解压到所有服务器上相同的目录。版本选择上,3.8.6 是当前的 stable 线,老版本的 3.7.x 已从 downloads.apache.org 当前版本区下架(历史版本要从 archive 站取):
1 | # 本文版本 3.8.6(downloads 站 stable 目录) |
tar 的 -C /opt 表示把压缩包内容直接解到 /opt 下,最后一步把带版本号的长目录名改成短的 /opt/zookeeper,后面所有配置和启动命令都按这个路径来。注意下载的是 -bin 包(编译好的二进制),不带后缀的同名包是源码,解压出来没有 bin 目录。
配置 ZooKeeper 集群
每个节点的配置大体相同,只有 myid 文件的内容需要按节点区分。
创建配置文件
ZooKeeper 自带一份示例配置,复制出来改:
1 | cp /opt/zookeeper/conf/zoo_sample.cfg /opt/zookeeper/conf/zoo.cfg |
在 zoo.cfg 里写入集群配置:
1 | tickTime=2000 |
几个关键参数的含义:
- tickTime:ZooKeeper 里最基本的时间单位,毫秒。
- initLimit:Follower 启动后与 Leader 完成同步的最长时间,超时会被判定异常。
- syncLimit:Leader 与 Follower 之间请求和应答的最大时限。
- dataDir:内存数据库快照和事务日志的存放位置。
- clientPort:客户端连接端口。
- server.X:X 是节点的唯一标识,zkX 是对应主机名,后面两个数字分别是节点间通信端口和选举端口。
三个节点的 zoo.cfg 完全一致,直接 scp 复制即可。
配置节点 ID
每个节点的 dataDir 目录下需要一个名为 myid 的文件,内容就是该节点在 zoo.cfg 里对应的那个数字:
1 | mkdir /var/lib/zookeeper |
注意最后三条 echo 分别在三台机器上执行,myid 的内容必须和 zoo.cfg 里 server.X 的 X 一一对应,写错一个节点整个集群就对不上号。部署完可以 for h in zk1 zk2 zk3; do ssh $h cat /var/lib/zookeeper/myid; done 交叉核对一遍。
启动和验证集群
三台机器分别启动服务:
1 | /opt/zookeeper/bin/zkServer.sh start |
这里有个实测发现的坑:三个节点首次启动时,start 命令可能输出 Starting zookeeper ... FAILED TO START,但进程其实已经起来了——start 脚本只等几秒就去探测客户端端口,而新集群第一次选举还没完成。以 status 为准,别信 start 的结束语:
1 | /opt/zookeeper/bin/zkServer.sh status |
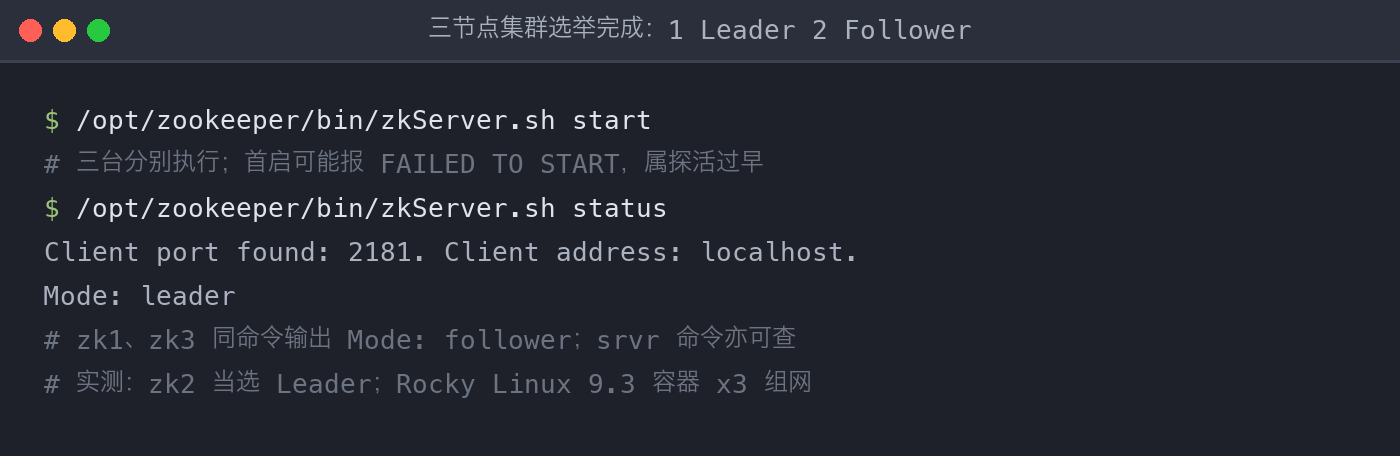
正常情况下每台节点报出 Mode: leader 或 Mode: follower,三台机器里恰好一个 Leader 带两个 Follower,集群就组建完成了。哪台报连不上集群,多数要回头查 myid 的内容或配置里的主机名解析。
集群状态也可以用四字命令 srvr 查:echo srvr | nc zk1 2181,输出里有 Zookeeper version 和 Mode 两行,适合塞进监控脚本。
功能验证:跨节点读写
选举成功只是第一步,数据能不能同步才算数。在一台节点写入、另一台读出:
1 | # 在 zk2 上创建节点 |
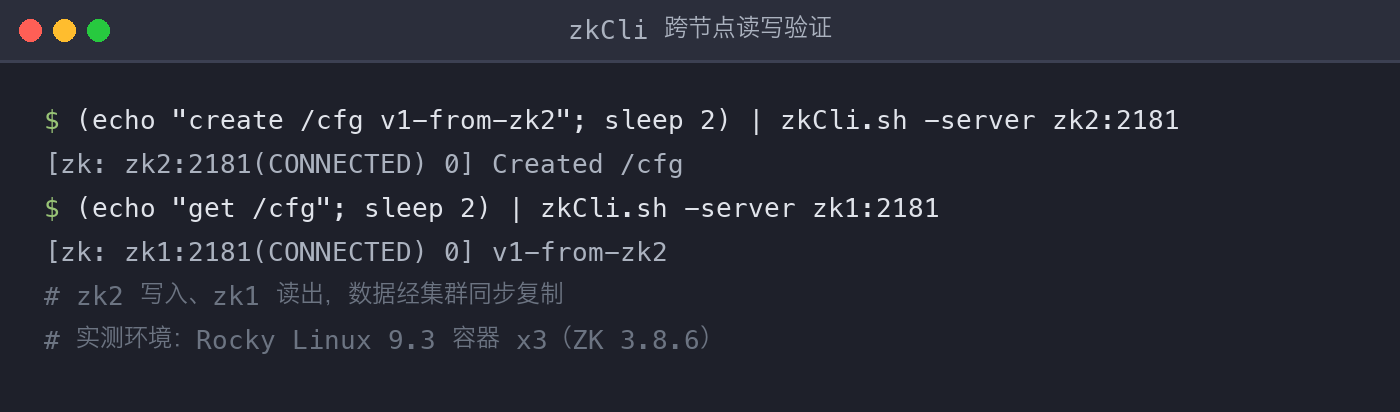
zk2 上返回 Created /cfg,zk1 上读出 v1-from-zk2,写读走了不同节点,说明集群复制链路是通的。
两个实测细节:其一,zkCli 的 create 不会递归创建父节点,直接 create /a/b/c 会报 Node does not exist: /a/b/c,要一层一层建;其二,节点重启后会自动重新加入集群——实测 stop 掉 follower 角色的 zk3 再 start,它重新以 follower 身份上线,数据无损。
常见报错
- start 报 FAILED TO START 但 status 正常:首次选举超出了 start 脚本的探测窗口,误报,不用处理;status 真报错的再按下面两条查。
- status 一直报 Error contacting service:通常是 myid 与 server.X 对不上、主机名解析不通、或 2888/3888 端口被防火墙拦了。三台分别核对 myid 内容,
getent hosts zk2确认解析,防火墙放行:firewall-cmd --add-port={2181,2888,3888}/tcp --permanent && firewall-cmd --reload。 - zkCli create 报 Node does not exist:父节点不存在,先建父路径。
- 想回退:
/opt/zookeeper/bin/zkServer.sh stop停服务,删掉/opt/zookeeper和/var/lib/zookeeper两个目录即完全卸载(dataDir 一删数据就没了,谨慎操作)。
历史版本差异(CentOS 7)
老读者从 CentOS 7 的部署流程迁过来,变化有三处:
- Java 包名:
java-1.8.0-openjdk换成java-11-openjdk,ZooKeeper 3.7+ 支持 JDK 11; - 版本与下载:当年部署的 3.7.0 已转入 archive.apache.org,新部署建议直接用 stable 线的 3.8.6,配置格式完全兼容;
- 包管理器:
yum install对应dnf install,时间同步从 ntp 换成 chronyd。
zoo.cfg 的配置语法、myid 机制、启动脚本用法在两个系统上完全一致,老流程的知识全部复用。
注意事项
- 安全性:生产环境的 ZooKeeper 通信要走可信网络,可以用内置的 ACL 功能保护数据,2181 端口不要暴露公网。
- 持久化存储:dataDir 放在高可靠性的存储设备上,快照和事务日志都在这里,日志和快照分盘存放还能再提一档性能。
- 备份与恢复:定期备份 dataDir 目录,防止单点故障带来数据丢失。
- 监控:上线后配上监控和报警(srvr/mntr 四字命令即可取数),别等客户端报错才发现集群已经异常。
- 端口互通:zoo.cfg 里用到的 2181、2888、3888 端口需要跨节点可达,节点之间有防火墙时记得放行。
三节点 ZooKeeper 集群的部署,配置本身只有十几行,功夫都在验证上:status 确认选举、跨节点读写确认复制、重启一台确认自愈。这三步都过了,这套集群才敢交给上层组件用。
本文由作者 2020-2024 年间的 CSDN 博客文章重构而来,原发布于 CSDN。




