机械盘与固态盘 IO 优化:调度器、挂载参数与 LVM 缓存
服务器磁盘 IO 上不去时,先别急着换硬件——调度器、挂载参数、写缓存这些软件层面的调整往往就有明显收益。但这套手段在机械硬盘(HDD)和固态硬盘(SSD)上不能混着用:两种盘的瓶颈完全不同,给 HDD 减少寻道、给 SSD 减少无谓写入,才是各自对症的药。这篇按实例过一遍主要优化点,调度器、TRIM、atime 和 LVM 建卷都在 Rocky 9 容器里实跑验证过,命令和输出可以直接对照改。
实验环境
- Rocky Linux 9.3 容器(一次性
docker run --privileged,lvm2 2.03.33、e2fsprogs 1.46.5、sysstat 12.5.4); - 容器里没有真实机械盘,块设备用 loop 回环盘代替,命令语法与实机一致;
- 原文基于 CentOS 7,两代系统的差异在对应位置标明;
hdparm写缓存涉及真实 ATA 盘,容器无法模拟,未实跑。
先搞清楚盘的类型
两种盘的物理结构决定了优化方向完全不同:
- HDD 的瓶颈在旋转延迟和寻道时间。磁头跳来跳去的时间远多于真正读写的时间,随机 IO 一多吞吐就崩,优化思路是减少磁头动作、合并写。
- SSD 靠电子存取,没有机械部件,速度快得多,但有两个新问题:写入有寿命限制(P/E 次数),删除数据要先”擦”整块再写——这引出了 TRIM。
后面每个实例都会点明它服务哪一类盘。
实例一:给 SSD 选支持 TRIM 的文件系统
TRIM 是操作系统告诉 SSD”哪些块已经作废”的机制,SSD 据此回收失效块,延缓性能衰减、延长寿命。ext4 和 XFS 都支持 TRIM,SSD 推荐二者之一,格式化命令没有特殊之处:
1 | # 把 SSD 分区格式化为 ext4 |
关键在”回收”这个动作真的会发生。容器里用 loop 盘走一遍完整流程:建盘、格式化、挂载、写 600M 文件、删掉,再用 fstrim -v 让文件系统交出作废块:
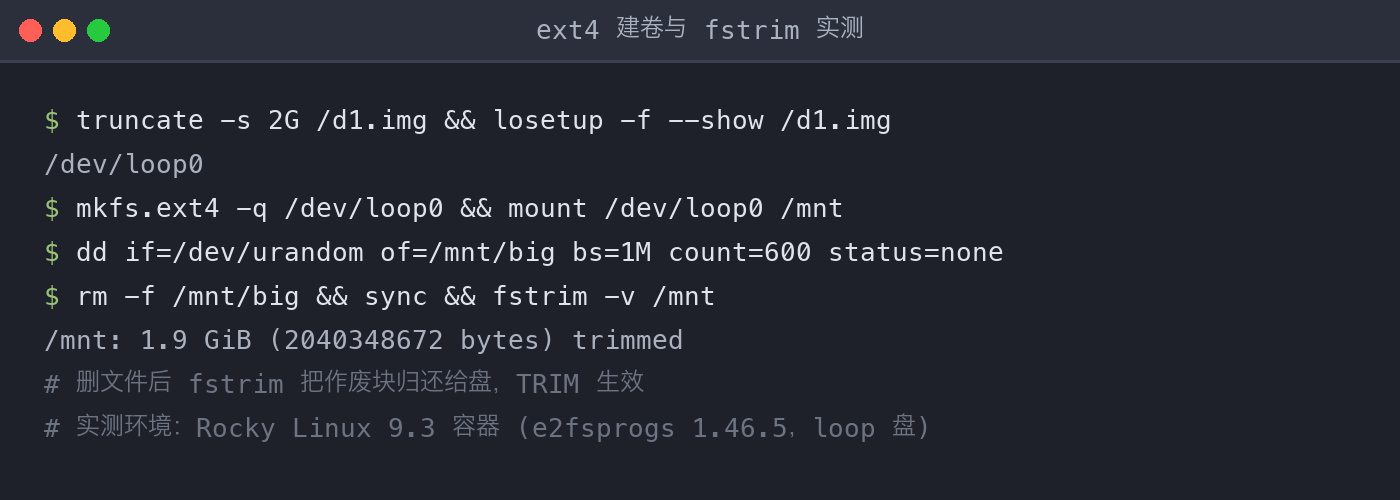
输出显示约 1.9 GiB 被回收——远大于刚删的 600M,因为格式化和写入过程中的元数据块也一并交还了。日常使用有两条路:挂载选项加 discard(每次删除实时 TRIM),或者用定时任务跑 fstrim,二选一即可。Rocky 9 预置了 fstrim.timer 每周执行一次,装完系统用 systemctl status fstrim.timer 确认它是 enabled 就不用再管;选了定时 fstrim 就不要再加 discard,重复做没有收益。
实例二:按盘类型选 I/O 调度器
调度器决定多个 IO 请求以什么顺序、什么并发度发给盘。CentOS 7 时代的选型口诀是 HDD 用 deadline、SSD 用 noop——但这条口诀到 Rocky 9 已经失效,因为调度器阵容换了。先看 Rocky 9 实际有哪些可选:
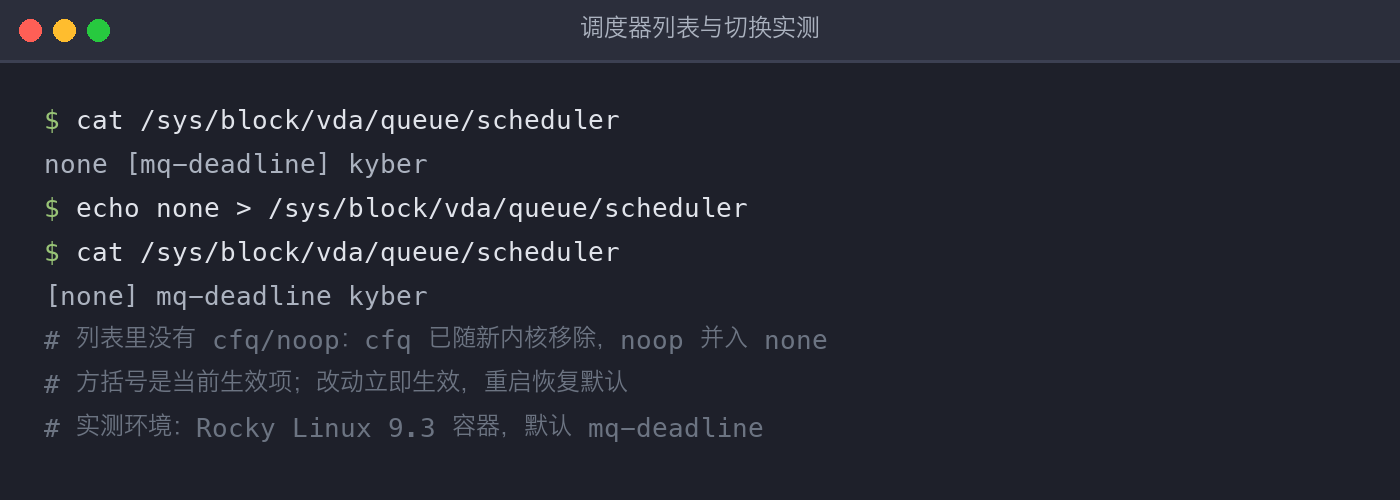
方括号 [mq-deadline] 是当前生效项。可选列表里没有 noop,也没有 cfq:cfq 随内核升级被移除,noop 的语义被合并进了 none。所以在新系统上照搬旧教程 echo noop > /sys/block/sda/queue/scheduler 不会报错,但也不会生效——这是新老系统之间最容易踩的坑,整理成对比:
| 写法 | CentOS 7 | Rocky 9 实测结果 |
|---|---|---|
echo noop > .../scheduler |
生效(noop 在列) | 无效,写完还是原调度器 |
echo deadline > .../scheduler |
生效 | 无效,列表里没有 deadline |
echo none > .../scheduler |
无此选项 | 生效 |
echo mq-deadline > .../scheduler |
无此选项 | 生效 |
Rocky 9 上的正确选型:HDD 和通用负载用 mq-deadline(给请求设期限,压缩平均等待时间),SSD 用 none(没有寻道开销,不需要请求重排,多队列直接下发反而省 CPU);列表里的 kyber 面向低延迟 NVMe 场景,一般不必主动换。
改动是运行时生效、重启即失,持久化两条路任选:写 udev 规则,或在内核参数里加 elevator=mq-deadline。
1 | # udev 规则示例:/etc/udev/rules.d/66-scheduler.rules |
CentOS 7 的机器不受影响,按原文写 noop/deadline 即可。
实例三:打开 HDD 的写缓存
写缓存把写入先落进盘上的缓存再慢慢刷盘,对 HDD 的写性能提升很直接:
1 | hdparm -W 1 /dev/sda |
代价是掉电时缓存里没来得及刷的数据会丢——数据库服务器通常宁可关掉它,普通文件服务器可以放心开。
注:此命令未实跑(需要真实 ATA 盘,容器无法模拟),用法来自原文与 hdparm(8) 手册。
实例四:挂载时加 noatime
Linux 会记录每个文件的访问时间(atime),也就是说读操作其实也在产生写。很多发行版已经用 relatime 缓解(只有在 atime 比 mtime 旧等条件下才更新),但这个”打折”依然存在。挂载时加 noatime 彻底关掉它,HDD 和 SSD 都适用。容器里把两种模式各跑一遍,用 stat -c %x 观察 atime:
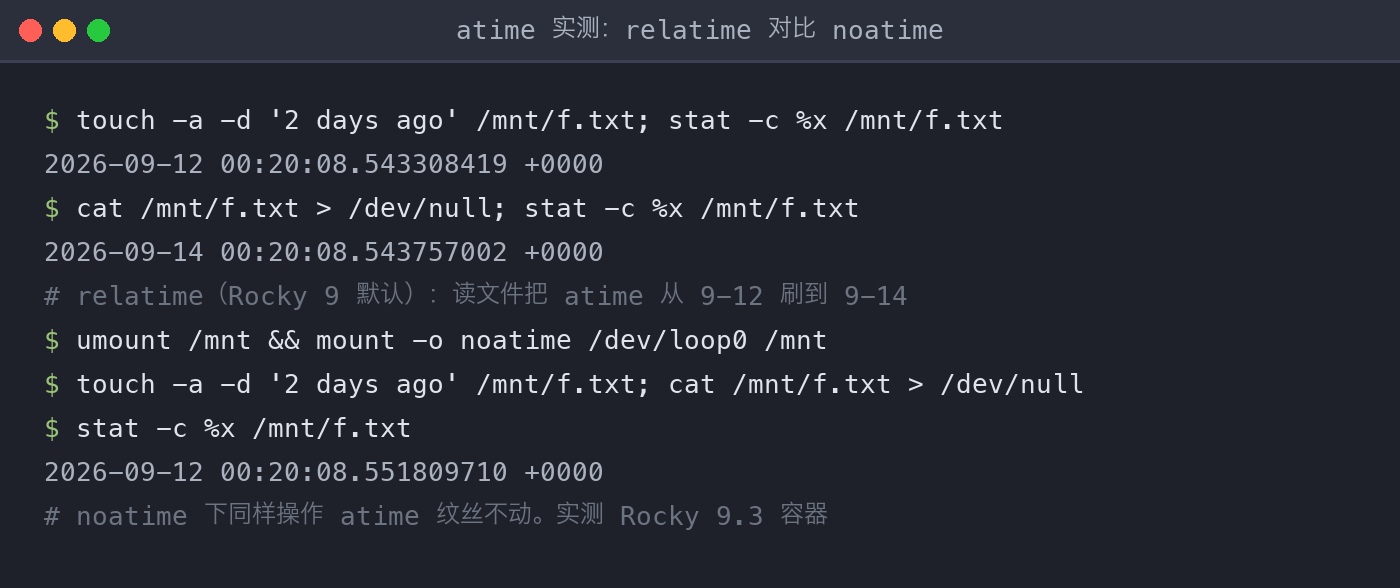
默认 relatime 下读一次文件,atime 从 9-12 被刷成当天;换成 noatime 后同一操作 atime 纹丝不动——读就是纯读。fstab 写法:
1 | # /etc/fstab 示例,为分区加 noatime |
改动后 mount -o remount / 立即生效,不需要重启。注意有极少数应用真的依赖 atime(如某些邮件投递工具按读取时间清理),上线前确认没有这类依赖。
进阶:RAID 与 LVM 缓存
对读写性能要求高的应用,可以把盘组成 RAID 10,兼得可靠性和性能。
混合环境(SSD + HDD 共存)下,更省钱的办法是用 LVM 的缓存功能,拿 SSD 给 HDD 当加速层:先建物理卷和卷组,再划出数据卷和缓存卷,最后把缓存卷绑定到数据卷上。前三步在容器里实跑验证(两个 loop 盘代替机械盘和 SSD,lvm2 2.03.33):
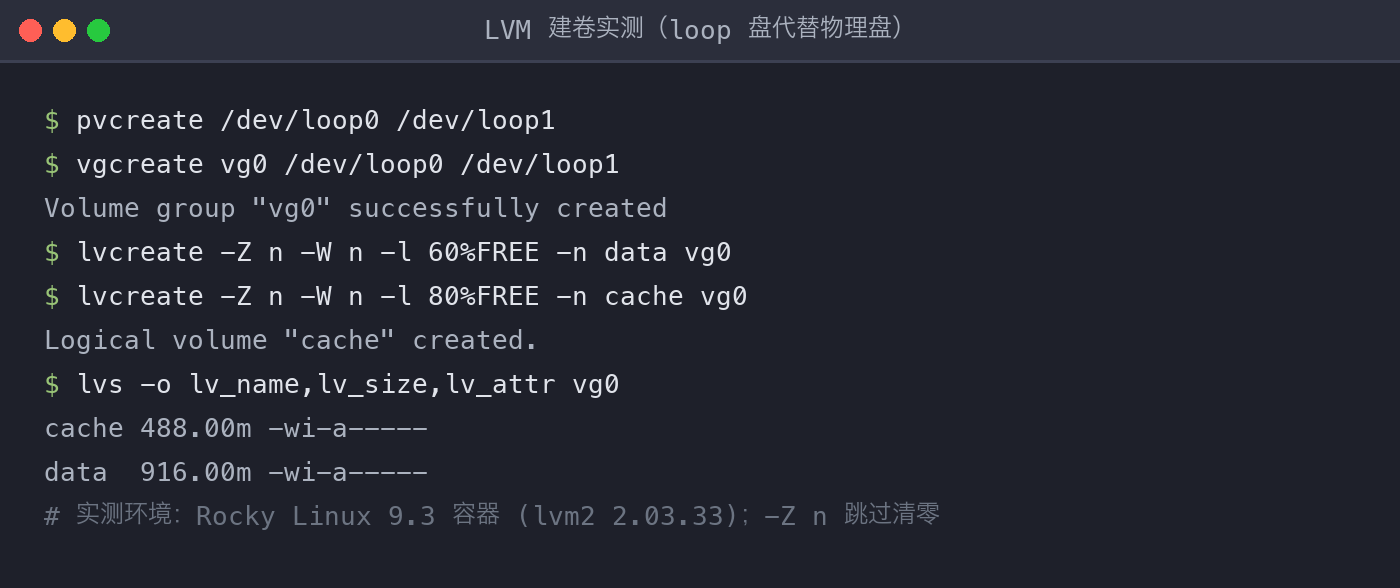
lvs 里 data 和 cache 两个逻辑卷都建出来了,卷大小跟百分比参数一致。最后一步绑定用 lvconvert --type cache --cachevol cache vg0/data,它依赖内核 dm-cache 模块——实验容器所在虚拟机没有这个模块,绑定没能跑通,正好把真实报错留给读者对照:
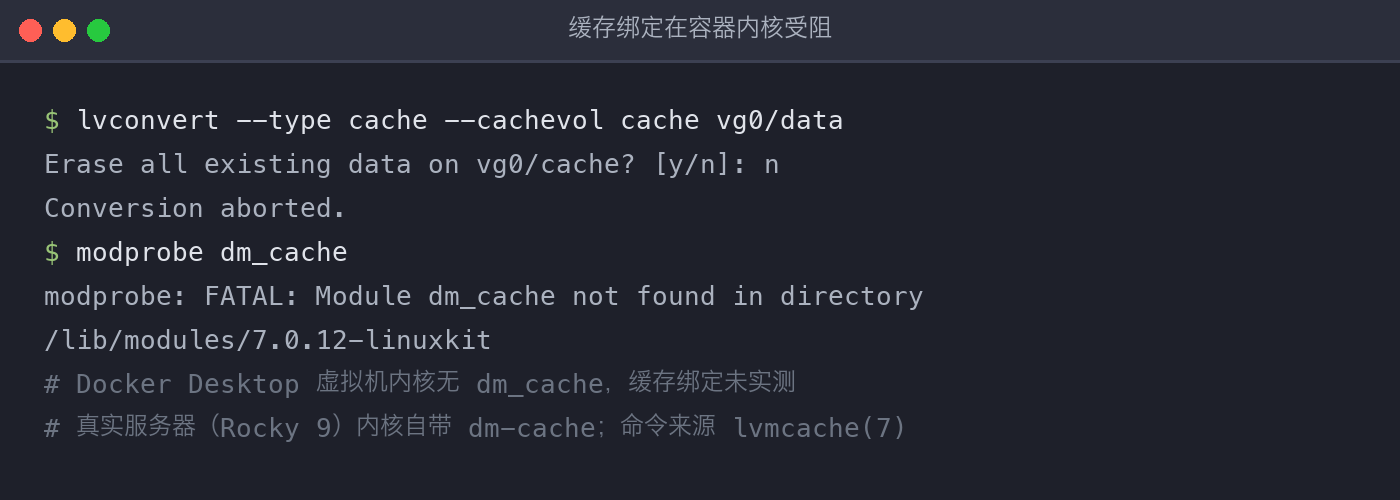
注:缓存绑定命令未实跑,用法来自 lvmcache(7) 手册。真实服务器(CentOS 7.5+ / Rocky 9)内核自带 dm-cache,命令照抄即可;如果你的内核也报 dm_cache 缺失,先确认
modprobe dm_cache,再考虑换内核。
绑定成功后热数据会被 LVM 自动搬到 SSD 那一层,HDD 提供大容量,SSD 提供速度,对应用完全透明。
改完要用 iostat 验证
优化不是改完就收工——参数是给别人抄的,收益是自己的,前后对比才算数。sysstat 包的 iostat 是最顺手的观察工具,容器里对着一块正在被 dd 直写的 loop 盘采样:
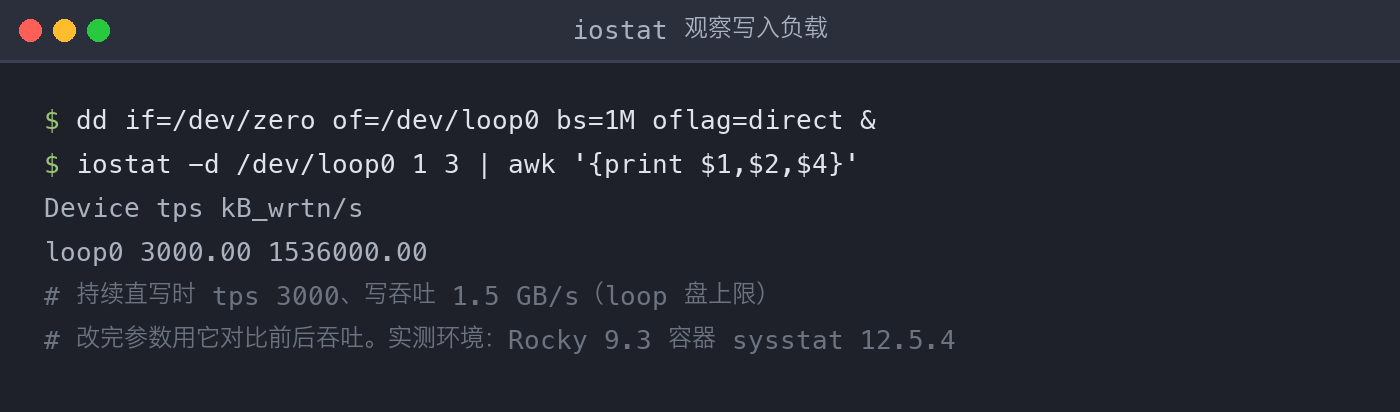
写入期间 tps 逼近 3000、写吞吐约 1.5 GB/s,数字与负载吻合,说明观测手段本身是通的。实战里同样的命令在改动前后各跑一轮(或配合 sar 看趋势),吞吐或 await 有真实改善,这次优化才算完成。
注意事项
- 动磁盘配置前先备份,调度器和缓存参数改错了轻则性能变差,重则丢数据。
- 优化参数要结合自己的硬件和业务负载调整,别人的配置只能当起点。
- 写缓存和调度器这类运行时修改重启就失效,上线前确认持久化方案(udev 规则或内核参数)。
- 新旧系统命令不通用:CentOS 7 的 noop/deadline 写法在 Rocky 9 上无效,反之亦然,跨机器迁移脚本前先核对调度器列表。
- 改完要持续观察优化效果,iostat、sar 看趋势,别凭感觉宣布胜利。
小结
回到开头的场景:IO 上不去,先分清手里是 HDD 还是 SSD——HDD 靠 mq-deadline 和写缓存减少机械动作,SSD 靠 TRIM 和 noatime 减少无谓写入,混合环境用 LVM 缓存把两边的长处拼起来。这四组实例都在 Rocky 9 上验证过命令与输出,唯一没跑通的 dm-cache 绑定也把报错原样留在了上面。改完别忘了两件事:运行时参数要持久化,效果要用 iostat 验证。软件层面榨干之后还不够,再谈换硬件。
本文由作者 2020-2024 年间的 CSDN 博客文章重构而来,原发布于 CSDN。