Nginx 连接超时排查:四个 timeout 参数的分工与实测
Nginx 后面挂的应用一旦响应变慢,超时问题就来了:用户侧看到的是页面转圈后一个 504,日志里是一行 upstream timed out。但 Nginx 里名字带 timeout 的指令有十几个,连接超时到底归谁管、该调哪一个,不把参数分工搞清楚,调参就是碰运气。这篇把 keepalive_timeout 和 proxy_* 三个超时参数放进一次请求的完整链路里讲清楚,给出一套面向长耗时应用的基线配置,并用容器实测展示读超时触发 504 的完整现场。
实验环境
结论要能复现,先交代条件:
- nginx/1.31.5(docker 镜像
nginx:alpine,一次性容器,用完即删); - 同一容器内用
nc起一个”只收请求、不回响应”的静默后端,模拟慢应用; - 每轮改动配置后
nginx -s reload,用curl验证状态码和耗时。
四个参数各管一段
核心机制一句话:一次代理请求横跨”客户端↔Nginx↔后端”两段链路,每个超时参数只守其中一段,先分清链路再调参。
| 参数 | 守护的链路段 | 触发后的表现 |
|---|---|---|
keepalive_timeout |
客户端 ↔ Nginx,连接空闲保持时长 | Nginx 关闭空闲连接,客户端下次请求重建连接 |
proxy_connect_timeout |
Nginx → 后端,TCP 建连 | 504,日志 while connecting to upstream |
proxy_read_timeout |
Nginx ← 后端,等待响应数据 | 504,日志 while reading response header |
proxy_send_timeout |
Nginx → 后端,发送请求体 | 504,日志 while sending request to upstream |
两个最容易误解的点,先说清楚:
proxy_read_timeout不是“整个响应必须在 N 秒内完成”,而是”相邻两次读到数据之间不能超过 N 秒”。只要后端持续有数据吐出,跑十分钟的长响应也不会触发它;反过来,后端静默 3 秒、3 秒后照样能给出结果,2 秒的读超时也会把它掐死。慢接口要不要调大它,取决于后端是”慢但在动”还是”先静默后出结果”。keepalive_timeout管的是客户端侧的连接复用,和后端没有任何关系。后端慢的时候调它,是调错了对象。proxy_send_timeout是最容易被忽略的一个:它管的是 Nginx 把请求体发给后端的过程,”相邻两次写之间”的间隔上限。客户端上传大文件而后端接收缓慢时才会碰到它,普通接口流量小,几乎永远触发不了。
实例一:长耗时应用的基线配置
给一个后端交互时间较长的应用配 Nginx,超时相关部分这样写:
1 | server { |
取值的考虑:proxy_connect_timeout 设 30 秒已经是宽裕的上限——建连失败基本意味着后端挂了或网络不通,等再久也没有意义,实践中很多团队直接压到 5-10 秒快速失败;proxy_read_timeout 设 300 秒,给”先静默处理、最后一次性返回”的长耗时请求留足余量;keepalive_timeout 设 300 秒是为了让浏览器复用连接,省掉反复三次握手的开销,对静态资源多的页面收益明显。
配置写完先让 Nginx 自己检查一遍:
1 | nginx -t |
实测输出 syntax is ok / test is successful,说明配置语法层面可以放行。nginx -s reload 生效后,再进入下一节的实测。
实例二:读超时触发 504 的完整现场
为了看清 proxy_read_timeout 的行为,把后端换成一个”收到请求后一声不吭”的静默服务(nc 监听 9001 端口,收下请求但不回任何字节),读超时设成 2 秒,然后 curl 它:
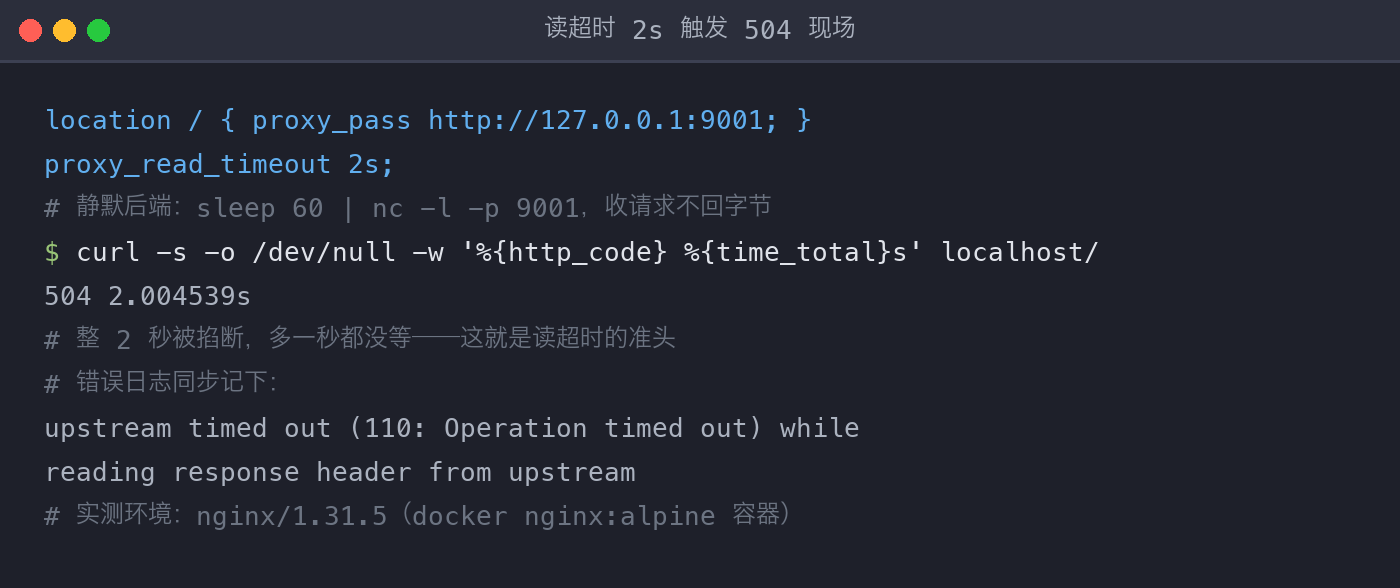
两个细节值得读出来:其一,耗时是 2.005 秒——从请求到达后端起整 2 秒被 Nginx 掐断,多一秒都没等,这就是读超时的准头;其二,状态码是 504 Gateway Time-out,而不是 502。504 = 后端还在但太慢(超时),502 = 后端连接被断开或返回了非法响应,排查时第一眼先分清这两个码。
反向验证也有价值:同一套配置,把后端换成正常应答的服务,同样的请求毫秒级返回:
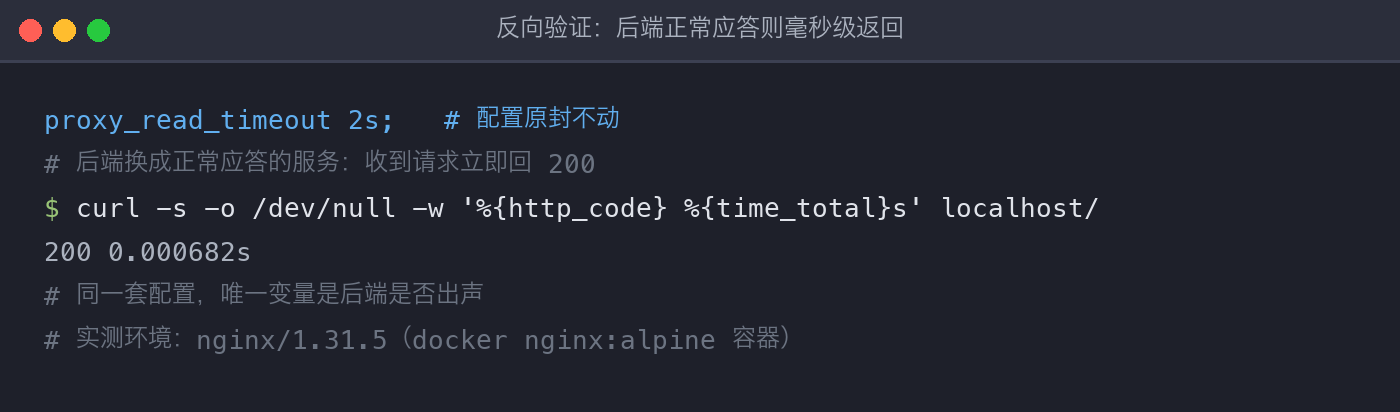
200 加上 0.7 毫秒的耗时证明,504 的唯一变量就是”后端 2 秒内没吐出响应头”,而不是配置里其他参数。
这个静默后端本身值得收进工具箱:sleep 60 | nc -l -p 9001 一行就能造出一个”收下请求但绝不应答”的服务,用来验证代理层超时、测试监控告警是否接得住 504,比在应用里埋 sleep 干净得多——应用代码里的延迟往往会分散在多个环节,而它给出的是纯粹的超时现场。
实例三:keepalive_timeout 的第二个参数
keepalive_timeout 有个少有人用的第二参数,专门用来告诉客户端”这个连接还能复用多久”:
1 | keepalive_timeout 60s 15s; |
第一个参数 60s 是 Nginx 实际关闭空闲连接的时长;第二个参数 15s 会写进响应头。实测一个简单接口的响应头:
1 | curl -si http://127.0.0.1/ka |
实测响应头:
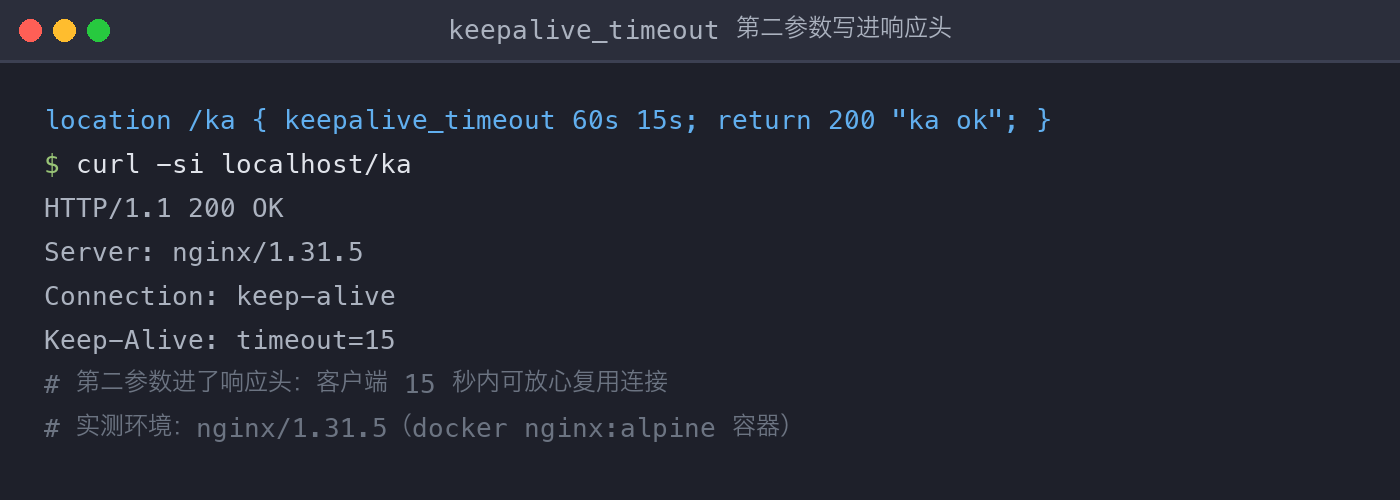
Connection: keep-alive 和 Keep-Alive: timeout=15 两行同时出现——第二个参数生效了。浏览器读到这个头,就知道连接在 15 秒内可以直接复用。第二个参数小于等于第一个即可,让客户端在连接被关之前主动换新,比撞上服务端强关再重连要顺滑。
需要注意:HTTP/1.1 下连接复用是默认行为,keepalive_timeout 0 会退回”一连接一请求”的短连接模式——除非在压测或某些特殊中间层场景,一般不建议。
两种典型错误写法
错误一:后端慢,去调 keepalive_timeout
1 | # 错:后端处理慢,调客户端连接保持时长,毫无作用 |
错在哪:keepalive_timeout 守的是客户端↔Nginx 这段空闲连接,后端处理再慢它也不参与计时。调了之后超时照旧,还让客户端连接白白多挂 10 分钟。
错误二:读超时无脑拉到 1 小时
1 | # 错:故障请求会占用 worker 整整一小时 |
错在哪:每个等后端响应的请求都占着一个 worker 连接。后端一旦抽风,成百上千个请求按 3600 秒排队,worker 池迅速耗尽,健康的请求也进不来了——一个慢后端拖垮整个 Nginx。
注意事项
- 超时参数不是越大越好。读超时拉得太长,故障请求会长时间占用 worker 连接,高峰期反而拖慢整体服务。按后端真实耗时的 P99 加余量设置,比统一拉满更稳。
- connect 类和 read 类超时的日志特征不同,这是排查的钥匙。
upstream timed out ... while connecting to upstream基本是后端进程挂了或网络不通;while reading response header是后端活着但处理太慢。看到日志先认这个后缀,方向立刻清楚一半。 - 方向别搞混。
keepalive_timeout管客户端侧连接复用,proxy_*三个参数管 Nginx 到后端方向,两段链路互不相干,调参前先问”这段超时发生在谁和谁之间”。 proxy_connect_timeout与proxy_send_timeout的触发条件本文未实跑:单机与容器环境里建连要么立即成功要么立即被拒,造不出”静默丢包”的网络路径。两者的行为描述来自 nginx 官方文档 ngx_http_proxy_module,生产环境中它们通常保持默认 60s 或略调小即可。
小结
回到开场的 504:下次再遇到,先翻错误日志认后缀——while connecting 去查后端存活和网络,while reading 去查后端耗时并考虑调大 proxy_read_timeout。四个参数各守一段链路:keepalive_timeout 管客户端复用,proxy_connect_timeout 管建连,proxy_read_timeout 管等响应,proxy_send_timeout 管发请求。先分清链路再动参数,超时调优就从碰运气变成了照图施工。
本文由作者 2020-2024 年间的 CSDN 博客文章重构而来,原发布于 CSDN。